LLMの量子化
LLMモデルの
- LLMは
多くの 場合は 数十億の パラメータを 超え、 高速な 推論の ためには 大規模なVRAMを 備えたGPUが 必要 - その
ため、 トレーニングや アダプターの 改良に より モデルを 小型化する 研究が 増えている - この
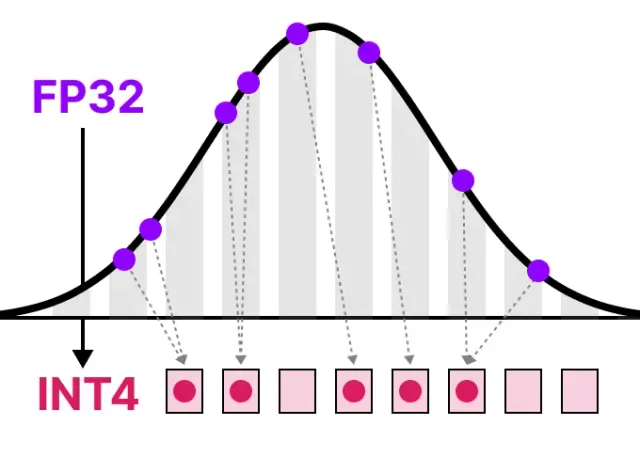
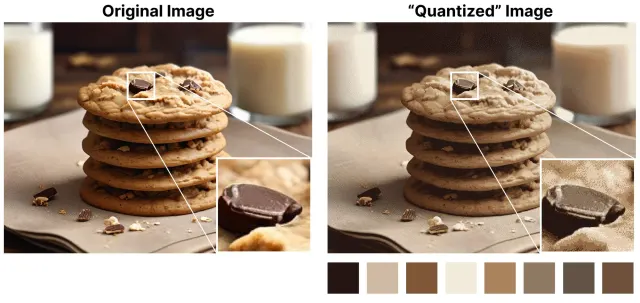
領域の 主要技術の 一つが 量子化 Quantization である
- この
特定の
-
- 64-bits = 64/8 × 70B → 560GB
- 32-bits = 32/8 × 70B → 280GB
- 16-bits = 16/8 × 70B → 140GB
- FP16精度すら70Bモデルの
ロードに140GBメモリが 必要
- FP16精度すら70Bモデルの
ref: